05 - 采样与数据管道
前置:04 篇的内容采集档位 —— 记不记 prompt 直接决定本篇所有数字。
本篇回答:这些数据一天几个 T,怎么少存又不丢关键信息。以及为什么传统 APM 那套采样配置搬到 Agent 上会失效。
本篇会用到的词:
| 词 | 意思 |
|---|---|
| 头采样(head sampling) | 在 trace 刚开始时就决定采不采。快、省内存,但那时你还不知道这次执行会不会出错 |
| 尾采样(tail sampling) | 等一棵 trace 的 span 收得差不多了再决定。能按结果筛选,代价是要把 span 攒在内存里 |
| Collector | OpenTelemetry 的数据管道进程。收 → 处理 → 转发,是做采样、脱敏、归一的地方 |
| OTLP | OpenTelemetry 的传输协议。SDK 发给 Collector、Collector 发给后端,走的都是它 |
| 基数(cardinality) | 一个属性有多少种不同取值。user_id 基数百万,model 基数几十 —— 高基数属性做成指标标签会把时序库打爆 |
| span metrics | 从 span 里现算出来的指标。它在采样之前算,所以采样丢掉的 trace 仍然计入统计 |
一、Agent trace 有三个反常特征
先把体积算清楚,因为后面所有决策都建立在这个数字上。
1.1 一天到底多少数据
假设:日均 1,000 万次 Agent 执行,每次平均 8 个 span,其中 3 个是模型调用。
| 内容采集档位(04 篇) | 单 span 均值 | 每次执行 | 日增量 | 30 天留存 |
|---|---|---|---|---|
| 档位 1:不记 prompt | 0.6 KB | 4.8 KB | 48 GB | 1.4 TB |
| 档位 2:记在 span 属性上 | 8 KB | 64 KB | 640 GB | 19 TB |
| 档位 2 + 长上下文(32K prompt) | 45 KB | 360 KB | 3.6 TB | 108 TB |
(按 1 token ≈ 3 字节 UTF-8 中文估算;实际值随业务差异很大,重点是量级不是精度)
记不记 prompt,差 13 倍;长上下文场景差 75 倍。 这就是 04 篇第三档"存到外部存储、span 上只留引用"的经济动机 —— 对象存储的单位成本比 OLAP 数据库低一到两个数量级,而 prompt 是"偶尔要看一眼、从不用来做聚合查询"的典型冷数据。
二、头采样在 Agent 上没什么用
传统做法是在 SDK 侧配一个比例:
# ❌ 这个配置在 Agent 场景下几乎等于关掉了排查能力
#    问题在于「决定采不采」发生在根 span 创建的那一刻,
#    而那时这次执行有没有出错、绕了几步、花了多少钱,全都还不知道
sampler = TraceIdRatioBased(0.1)      # 只留 10%
传统服务里这么做还行,因为请求高度同质 —— 随机留 10% 得到的是一个有代表性的样本。Agent 不是:
| 特征 | 后果 |
|---|---|
| 失败率低但失败很贵 | 1% 的失败请求里,10% 采样后只剩 0.1%,样本量不够定位 |
| 长尾极重 | 你要查的永远是那条 90 秒的、绕了 40 步的执行,而它被随机丢掉的概率和别的一样 |
| 成本分布极不均匀 | 少数请求消耗大部分 token,采样后的成本统计与真实账单对不上 |
头采样唯一还成立的用法,是给 Collector 做限流兜底 —— 防止某个服务突然发疯把管道打爆,而不是作为常规策略。
三、尾采样的三个前提,Agent 打破了两个
尾采样处理器(tailsamplingprocessor,beta 阶段)的做法是把 span 攒在内存里,等一段时间后按策略判断。它有三个隐含前提。
3.1 前提一:trace 在 decision_wait 内结束
processors:
  tail_sampling:
    decision_wait: 30s      # ← 默认值
    num_traces: 50000       # ← 默认值,内存里最多攒这么多棵树
默认等 30 秒。 一次带工具调用的 Agent 执行经常超过这个数,01 篇开头那个例子就是 18.4 秒 —— 已经接近了。
超时会怎样?官方文档里"Late-Arriving Spans"那一节写得很清楚:
Late spans can cause different sampling decisions for different parts of the trace.
一棵树被劈成两半,前半段留下、后半段丢掉。 这比整棵丢更糟 —— 你在后台看到一棵结构完整的 trace,但它缺了最后那几个 span,而"最后那几个 span"往往正是出错的地方。
调大 decision_wait 又会撞上前提二。
3.2 前提二:内存装得下
num_traces 默认 50,000,实现是一个环形缓冲区:新的 trace 进来,最老的被挤出去 —— 哪怕它还没到 decision_wait。
内存占用大致是 num_traces × 每棵树的字节数。代入 1.1 节的数字:
| 场景 | 每棵树 | × 50,000 | 结论 |
|---|---|---|---|
| 不记 prompt | 4.8 KB | 240 MB | 可接受 |
| 记 prompt | 64 KB | 3.2 GB | 单个 Collector 实例扛不住 |
记 prompt + decision_wait: 120s | 64 KB | 需要把 num_traces 再放大 4 倍 | 12.8 GB,不现实 |
这条路径上的两个官方指标必须上监控:
# 被环形缓冲挤掉、还没做采样决策就没了的 trace 数。非 0 就说明配置不够用
otelcol_processor_tail_sampling_sampling_trace_dropped_too_early

# trace 在缓冲区里待了多久才被移除。看它的 p1 分位 ——
# 如果 p1 已经接近 decision_wait,说明流量再涨一点就会开始丢
otelcol_processor_tail_sampling_sampling_trace_removal_age
结论:想开尾采样,就别在 span 属性上记 prompt。 这两件事在内存上是直接冲突的,而 04 篇第三档(内容外置 + span 留引用)正好同时解决两边。
3.3 前提三:同一棵树进同一个实例
这条不是 Agent 特有的,但 Agent 场景下更容易踩,因为一棵树跨的服务更多。
All spans for a given trace MUST be received by the same collector instance for effective sampling decisions.
在讲两层拓扑之前,先看一个 Collector 里面装了什么 —— 后面说的「在 Collector 里做采样、脱敏」,指的都是中间那一段:
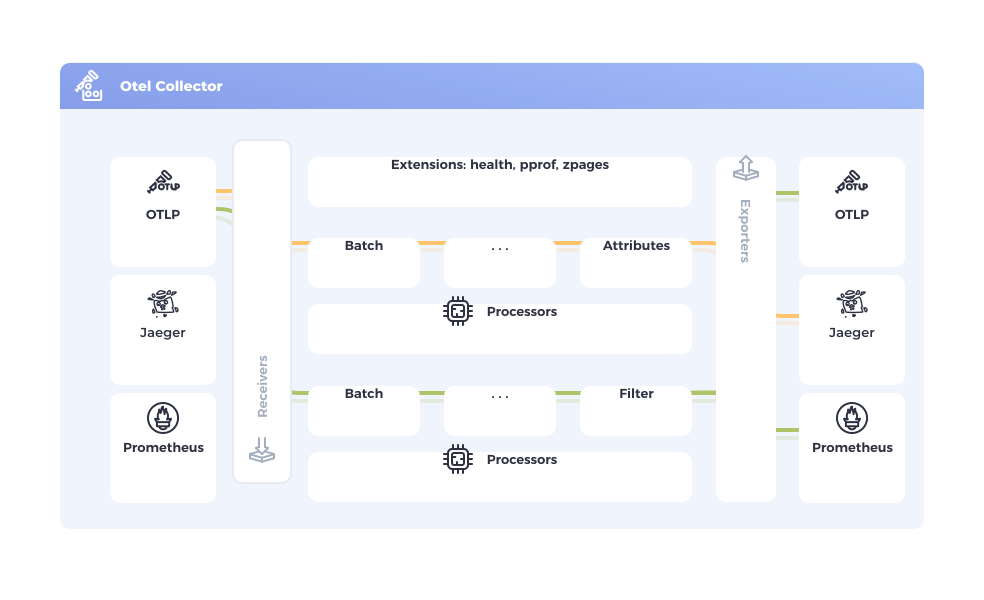
docs/collector/img/otel-collector.svg,CC-BY-4.0。收(Receivers)→ 处理(Processors)→ 发(Exporters)三段是可以自由拼的流水线,同一个进程里能并存多条。尾采样、脱敏、按标记丢弃重放 span,全都是往中间那段插一个 processor —— 这也是为什么这些事该在 Collector 做,而不是改应用代码。普通的负载均衡按连接分发,同一棵树的 span 会散到不同实例,每个实例都只看到残缺的树。官方给的解法是两层 Collector:
四、对 Agent 有意义的采样策略
处理器支持十几种策略,但对 Agent 真正有价值的是这几条 —— 关键在于它们筛的是"这次执行行为异常",而不是"这次请求出错了":
processors:
  tail_sampling:
    decision_wait: 60s                 # 按你的 P99 执行时长定,不是拍脑袋
    num_traces: 20000                  # 配合 1.1 节的体积算内存,别用默认值
    maximum_trace_size_bytes: 5242880  # 5MB。超大的树直接丢,保护 Collector 自身
    policies:
      # ① 出错的全留。这是所有场景的底线
      - name: errors
        type: status_code
        status_code: {status_codes: [ERROR]}

      # ② 慢的全留。阈值取 P95 而不是 P99 —— 你要的是「开始变慢」的样本
      - name: slow
        type: latency
        latency: {threshold_ms: 30000}

      # ③ 步数异常的全留。这条是 Agent 独有的,传统 APM 没有对应概念:
      #    同一个问题模型绕了 30 步以上,说明它在反复试探,
      #    即使最后成功了也是需要看的样本(见 01 篇 3.2 节)
      - name: too-many-steps
        type: span_count
        span_count: {min_spans: 30}

      # ④ 贵的全留。用 OTTL 直接读 span 属性,
      #    单次调用输入超 5 万 token 通常意味着上下文管理出了问题
      - name: expensive
        type: ottl_condition
        ottl_condition:
          span:
            - 'attributes["gen_ai.usage.input_tokens"] > 50000'

      # ⑤ 剩下的按比例留,保证「正常样本」也有基线可比
      - name: baseline
        type: probabilistic
        probabilistic: {sampling_percentage: 5}
策略之间是 OR 关系:任一命中即保留。所以①到④是"必留",⑤是兜底基线。
③和④是这份配置里唯二不能从传统 APM 抄来的。 传统服务的下游调用次数由代码写死,"步数"不是变量;token 用量更是不存在的概念。它们对应的正是 01 篇 3.2 节那两个"传统监控里没有的指标"。
4.1 别忘了指标是采样的补集
采样丢掉的 trace 不该同时丢掉它的统计价值。spanmetricsconnector 在采样之前从 span 里现算指标:
connectors:
  spanmetrics:
    dimensions:                          # 维度要挑基数低的
      - name: gen_ai.request.model       # 几十种,安全
      - name: gen_ai.operation.name      # 十八种,安全
      - name: tenant.id                  # ⚠️ 基数取决于租户数,几百可以,几十万会打爆时序库

service:
  pipelines:
    traces:
      receivers: [otlp]
      # 关键:spanmetrics 排在 tail_sampling 之前,
      # 这样被采样丢弃的 trace 仍然计入指标
      processors: [gen_ai_normalizer, redaction]
      exporters: [spanmetrics, tail_sampling_pipeline]
这样得到的分工是清楚的:指标全量、准确,用来告警和看趋势;trace 采样、有偏,用来查具体问题。 成本报表应该走指标而不是 trace —— 这一点 06 篇会展开。
五、后端存储
trace 到了后端还要落盘。这一层现在几乎被 ClickHouse 统一了:
| 后端 | 存储 | 说明 |
|---|---|---|
| Langfuse | ClickHouse(必需,≥ 24.3) + Postgres + Redis + 对象存储 | 官方明确写着"没有其他 OLAP 数据库可选" |
| SigNoz(★31,890) | ClickHouse | 通用可观测平台,兼做 GenAI |
| ClickStack | ClickHouse | ClickHouse 官方的开源可观测栈 |
| Grafana Tempo(★5,445,AGPL-3.0) | 对象存储 + 索引 | 通用追踪后端,GenAI 语义要自己在查询层拼 |
| Arize Phoenix | SQLite / Postgres | 单机起步,不为超大规模设计 |
Langfuse 的摄入路径值得单独看一眼,因为它解决的正是本篇 1.1 节那个体积问题:
写路径和读路径彻底分开,是这套架构的全部要点 —— 流量尖峰打不穿数据库,因为尖峰只会让对象存储多写几个文件,队列长度几乎不变。
对象存储在这里有双重身份:既是持久化缓冲(数据库挂了数据也不丢,恢复后 Worker 从原始事件重放),也是大字段的最终归宿(多模态输入、超长导出)。这与 04 篇的「内容外置」是同一个思路在不同层的应用。
自建时最容易漏的就是中间那两步。直接 SDK → 数据库的架构,在流量尖峰时会以超时形式丢数据,而且丢了就没了。
四个组件缺一不可,这也是 Langfuse「部署重」的来源 —— 评估自建成本要按四套中间件算,而不是按一个应用算。
生产规模的佐证:ClickHouse 于 2026-01-16 收购 Langfuse 时公布的数字是 SDK 月安装量 26M+、Docker 拉取 6M+、Fortune 500 里 63 家在用(其中 Fortune 50 占 19 家)。收购理由本身也说明问题 —— Langfuse 从一开始就建在 ClickHouse 上,LLM 可观测在数据层面就是一个 OLAP 问题。
六、别忘了重放
用了 Agent 持久化执行那套机制的系统,同一个逻辑步骤会在 trace 里出现多次 —— 因为故障恢复时工作流会从头重放,已完成的步骤走缓存但仍然产生 span。
对本篇的直接影响有两条:
| 影响 | 处理 |
|---|---|
| span 数量虚高 | 4.1 节那条 span_count: {min_spans: 30} 会把所有重放过的执行都判成"步数异常",规则要排除重放 span |
| 存储量虚高 | 重放 span 大多是重复内容,值得在 Collector 里用 filterprocessor 按标记丢掉 |
前提是埋点时给重放产生的 span 打上标记。这件事必须在设计阶段做 —— 事后从数据里区分不出来。详见 持久化执行 · 05 篇第三节。
下一篇 → 06 - 成本归因
← 回到 专题索引 · Agent Infra 板块总览